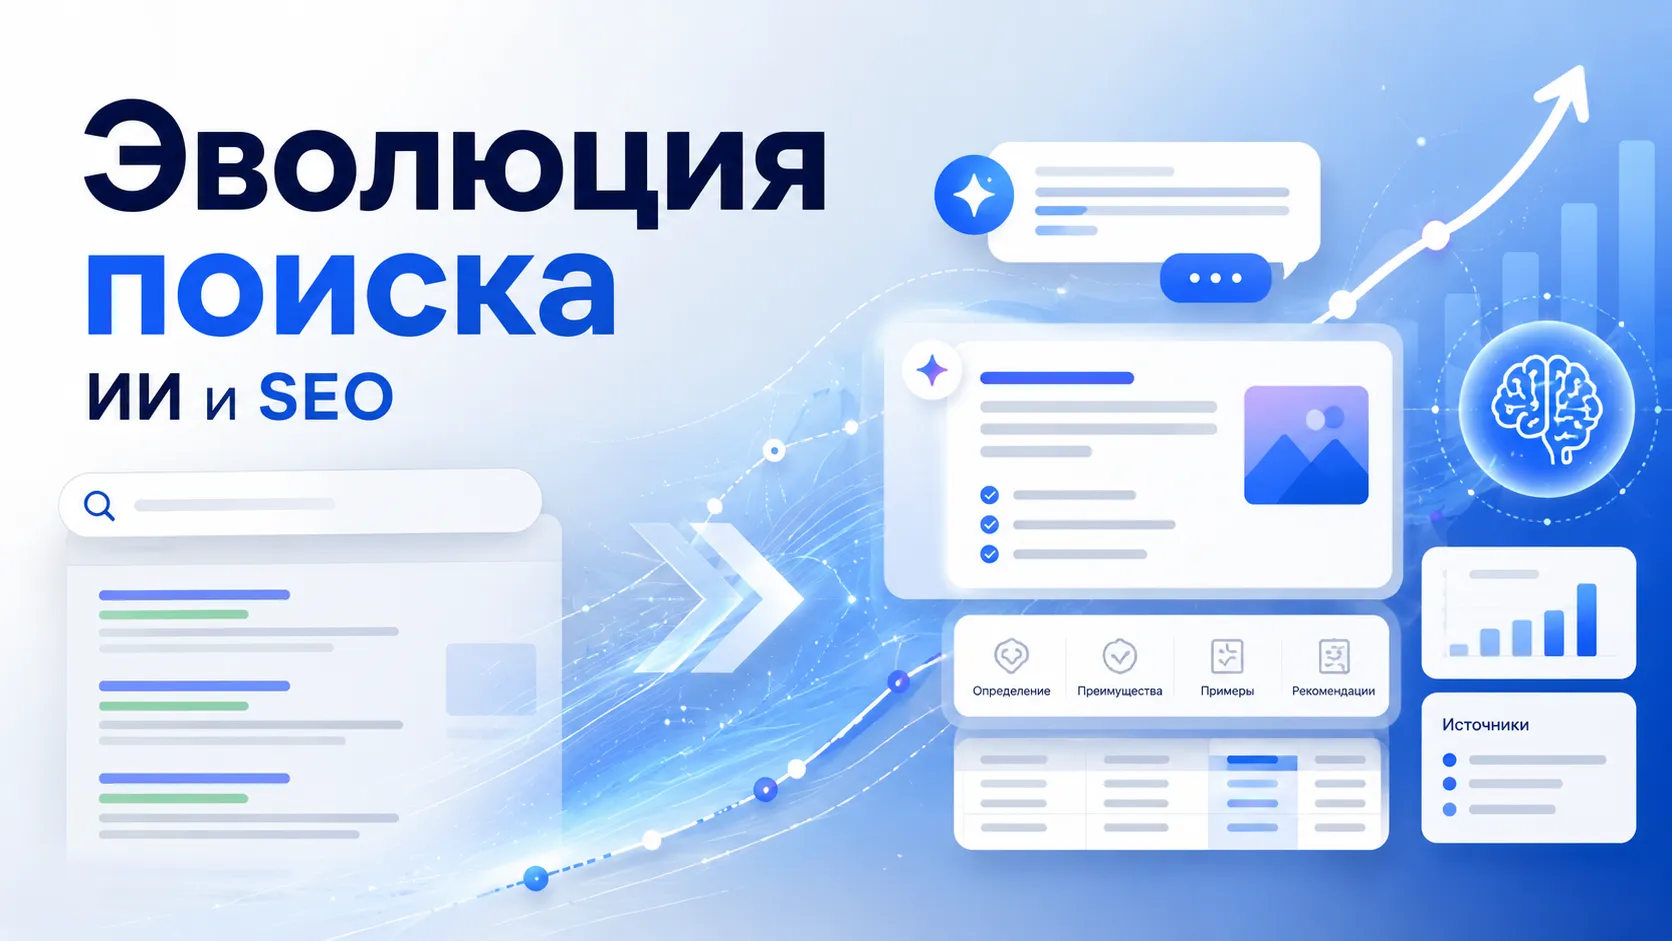
Поисковые системы окончательно перестали быть просто сборниками ссылок. Развертывание систем генеративного поиска (Search Generative Experience, или SGE) и интеграция больших языковых моделей в выдачу Яндекса и Google изменили базовый паттерн поведения пользователей. Вместо перехода на сайты для самостоятельного сбора информации люди все чаще читают готовый суммаризированный ответ прямо на странице поисковой выдачи (SERP).
Для коммерческих и информационных сайтов это означает падение традиционного органического трафика по классическим информационным запросам. Поисковые роботы нового поколения теперь выступают в роли жестких цензоров: они парсят контент, собирают выжимку и показывают ее пользователю, оставляя первоисточник в блоке мелких ссылок для проверки фактов. Чтобы выжить в этой экосистеме, стандартных методов оптимизации метатегов и закупки ссылочной массы уже недостаточно. Необходимо перестраивать архитектуру контента под логику работы нейросетей, стремясь попасть в блоки быстрых ответов и выдачу ИИ.
Архитектура генеративного ответа: как нейросети собирают информацию
Поисковые ИИ-модели не генерируют ответы из головы. Они работают на базе существующих в индексе документов, используя комбинированный подход: классический лексический поиск, семантический (векторный) анализ и последующую суммаризацию с помощью больших языковых моделей (LLM).
Процесс формирования умного ответа выглядит следующим образом:
- Анализ интента пользователя. Система переводит разговорный или сложный запрос в векторное представление, определяя истинную суть вопроса.
- Экстракция кандидатов. Из традиционного поискового индекса извлекаются текстовые фрагменты сайтов, которые имеют максимальную семантическую близость к запросу.
- Ранжирование кусков текста (Chunking). Нейросеть оценивает не страницу целиком, а конкретные абзацы, списки и таблицы на предмет их емкости и достоверности.
- Синтез ответа. Блок генерации перефразирует собранные данные, убирает дубли и формирует связный текст для пользователя, расставляя ссылки-сноски на источники.
Типичная ошибка веб-мастеров — пытаться спрятать важную информацию глубоко в теле статьи или заставлять пользователя совершать дополнительные клики. Если робот не сможет быстро извлечь законченную мысль из конкретного текстового блока, страница просто выпадет из пула кандидатов на генеративный ответ.
Мнение эксперта студии «Элегрант»:
«Раньше мы оптимизировали страницы под алгоритмы, которые оценивали плотность ключевых слов и авторитет домена. Сегодня нейросеть считывает микроконтекст. Если ваш абзац содержит размытые рассуждения вместо четкого факта, поисковый робот просто пролистает его и возьмет данные у конкурента, который сформулировал мысль лаконично».
Изменение пользовательского поведения и концепция Zero-Click Searches
Широкое внедрение умных ответов привело к лавинообразному росту кликов в ноль (Zero-Click Searches). Пользователь получает точный ответ на свой вопрос (например, «какой длины должен быть кабель для заземления» или «разница между типами фундаментов») прямо в поисковой выдаче.
Ниже приведено сравнение старой и новой модели взаимодействия пользователя с поиском:
| Критерий | Классическая модель поиска | Модель генеративного поиска (SGE / ИИ) |
|---|---|---|
| Действия пользователя | Ввод ключа -> Сравнение 3-5 сайтов -> Чтение | Ввод развернутого вопроса -> Чтение ответа ИИ |
| Глубина просмотра | Высокая (просмотр нескольких страниц сайта) | Крайне низкая (клик происходит только за деталями) |
| Характер запросов | Короткие маркерные фразы (2-3 слова) | Длинные разговорные фразы, уточнения |
| Ценность трафика | Высокий объем информационного трафика | Низкий объем, но высокая конверсия коммерческого трафика |
Практический опыт показывает: информационные сайты, зарабатывающие на показах баннерной рекламы, теряют значительную часть аудитории. В выигрыше остаются ресурсы, которые оптимизируют контент под глубокие, специфические запросы, где пользователю недостаточно короткой справки и требуется экспертное погружение или покупка конкретной услуги.
Конвергентное SEO: объединение подходов Яндекса и Google
Несмотря на технологические различия между экосистемами Яндекса (через инструменты Search API и YandexGPT) и Google (SGE / Gemini), их логика отбора сайтов-доноров для умных ответов совпадает. Обе системы стремятся минимизировать затраты на вычисления и отбирают контент, который подготовлен по принципам конвергентного SEO.
Этот подход требует одновременной работы над тремя компонентами:
- Техническая безупречность: высокая скорость отдачи контента, отсутствие мусорного кода, мешающего парсингу, корректные серверные ответы.
- Структурная четкость: деление текста на микроблоки, каждый из которых отвечает на один подвопрос.
- Авторитетность (факторинг): подтверждение каждого тезиса проверяемыми данными, отсутствие размытых формулировок.
Если сайт оптимизирован только под классические ключевые слова (например, содержит высокую плотность фразы «купить кондиционер в Москве»), но не предлагает развернутых ответов на сопутствующие вопросы пользователя, нейросеть проигнорирует его при формировании умного блока. В тренде экспертность, а не текстовая оптимизация старого образца.
Оптимизация текстовой структуры под парсинг ИИ-агентами
Чтобы алгоритмы генеративного поиска могли без труда использовать контент сайта, текст должен быть жестко структурирован. Нейросети любят логику и предсказуемость. Каждая статья или коммерческая страница должна строиться по принципу перевернутой пирамиды: сначала идет прямой, максимально емкий ответ на вопрос, затем — детали, примеры и технические подробности.
Основные правила структурирования контента для попадания в ИИ-выдачу:
- Один абзац — одна мысль. Оптимальный размер абзаца для ИИ-парсера составляет три-четыре предложения. Избегайте сложных деепричастных оборотов и многоэтажных конструкций.
- Использование списков для перечислений. Если в тексте идет перечисление этапов, преимуществ, характеристик или требований, их обязательно нужно оформлять через теги <ul> или <ol>. Роботы SGE часто забирают такие списки целиком прямо в выдачу.
- Прямые ответы в начале разделов. Подзаголовок H2 или H3 должен содержать конкретный вопрос (например, «Как проверить уровень масла в коробке автомат»), а первое предложение под ним должно начинаться с прямого ответа, без долгих вступлений.
Типичная ошибка: написание художественных текстов с лирическими отступлениями. Поисковый робот тратит лимиты на обработку страницы (crawl budget) и, натыкаясь на абзацы без фактической нагрузки, прекращает глубокий анализ документа.
Семантическая разметка и микроформаты: язык, который понимают алгоритмы
Микроразметка Schema.org стала главным мостом между человеческим текстом и базой знаний поискового ИИ. Она позволяет в явном виде указать роботам, какие сущности находятся на странице, как они связаны между собой и какую роль выполняют.
Для успешного попадания в умные ответы необходимо внедрять следующие типы разметки:
- FAQPage (Вопросы и ответы). Позволяет четко разметить блоки «вопрос-ответ». Нейросети используют эту разметку для быстрого извлечения фактов.
- Product (Карточка товара). Передает агрегированные данные о цене, наличии, характеристиках и отзывах. Алгоритмы генеративного поиска строят на их основе товарные карусели сравнения прямо в SERP.
- Article / NewsArticle. Помогает роботу определить автора материала, дату публикации и краткое описание, что критически важно для оценки актуальности информации.
- HowTo (Пошаговые инструкции). Идеальный формат для технических гайдов, рецептов и руководств. Позволяет ИИ пошагово выводить алгоритм действий в блоке ответа.
    <script type="application/ld+json">
    {
    "@context": "https://schema.org",
    "@type": "FAQPage",
    "mainEntity": [
        {
        "@type": "Question",
        "name": "Как ИИ влияет на позиции сайта в поиске?",
        "acceptedAnswer": {
            "@type": "Answer",
            "text": "ИИ-ассистенты снижают трафик по общим информационным запросам,
            но увеличивают ценность целевых переходов за счет вывода точных ответов
            со ссылками на авторитетные источники."
        }
        }
    ]
    }
    </script>
Отсутствие семантической разметки заставляет поисковый ИИ самостоятельно догадываться о значении элементов страницы. В условиях высокой конкуренции алгоритм выберет тот сайт, где данные уже структурированы с помощью JSON-LD.
Форматирование данных: таблицы и списки как ключевой триггер для SGE
Нейросети обучались на структурированных данных, поэтому таблицы и списки для них являются приоритетными зонами извлечения информации. Когда пользователь вводит запрос, требующий сравнения параметров или выбора из нескольких вариантов, SGE практически всегда генерирует ответ на основе существующих HTML-таблиц.
Правила создания таблиц для ИИ-оптимизации:
- Обязательное использование тегов <thead> и <tbody>. Робот должен четко понимать, где находятся заголовки столбцов, а где — сами данные.
- Лаконичность в ячейках. Не нужно помещать в одну ячейку таблицы целые абзацы текста. Используйте короткие фразы, числовые значения, маркеры «да/нет».
- Тематические ключевые слова в заголовках колонок. Это помогает семантическому анализатору связать параметры таблицы с интентом пользователя.
Чек-лист для проверки списков перед публикацией:
- Списки не должны быть слишком длинными (оптимально от трех до семи пунктов).
- Каждый пункт списка должен начинаться с активного глагола или существительного в одной и той же форме.
- Элементы списка должны содержать законченную мысль, чтобы при вырывании из контекста они не теряли смысл.
Сайты, которые заменяют сплошные простыни текста на аккуратные сравнительные таблицы, в большинстве случаев получают приоритет при формировании блоков быстрых ответов в Яндексе и Google.
Оптимизация под разговорные и длинные запросы (Long-Tail Keywords)
С развитием голосового ввода и чат-ботов пользователи перестали формулировать запросы рублеными фразами вроде «ремонт генератора москва цена». Теперь запросы выглядят как естественная речь: «что делать, если на панели загорелся значок аккумулятора и свистит ремень».
Работа с длинным хвостом запросов (Long-Tail) в эпоху ИИ строится на следующих принципах:
- Отказ от точного вхождения ключей. Современные поисковые системы понимают синонимы, контекст и скрытый смысл фраз. Нет необходимости спамить неестественными конструкциями.
- Создание разделов с вопросительными маркерами. Контент должен отвечать на вопросы: Что, Как, Почему, Сколько, Где, Какой.
- Группировка смежных интентов. Вместо создания под каждую микрофразу отдельной страницы (как это делалось раньше), необходимо создавать один масштабный, но детально проработанный материал, закрывающий группу связанных вопросов.
Реальный сценарий: компания по установке септиков создала страницу, где вместо сухого прайс-листа подробно разобрала ситуации: «какой септик выбрать для высоких грунтовых вод», «что происходит с канализацией зимой при редком использовании», «как часто нужно вызывать ассенизатора». В результате страница стала основным источником для умных ответов поисковиков по всему кластеру целевых низкочастотных запросов, обеспечив приток качественных лидов.
Работа со скрытыми факторами ранжирования: авторитетность автора и верификация
В эпоху, когда генерировать посредственный текст можно терабайтами с помощью базовых интерфейсов программирования приложений (API), поисковые системы резко повысили требования к верификации контента. Для Google это концепция E-E-A-T (Опыт, Экспертиза, Авторитетность, Достоверность), для Яндекса — метрики качества и доверия к источнику.
Нейросети оценивают авторитетность по косвенным и прямым признакам:
- Профиль автора. К каждой экспертной статье должна быть привязана карточка реального автора с указанием его образования, опыта работы, ссылками на профильные публикации и социальные сети.
- Внешние упоминания (цитируемость). Если имя автора или название бренда часто упоминаются на сторонних авторитетных площадках, форумах и в СМИ без прямой ссылки, поисковый ИИ связывает эти сущности и повышает общий уровень доверия к сайту.
- Проверяемые источники данных. Наличие исходящих ссылок на авторитетные отраслевые ресурсы, законы, официальные спецификации производителей подтверждает, что материал не придуман копирайтером на коленке.
Мнение ведущего аналитика студии «Элегрант»:
«Анонимный контент больше не работает. Если алгоритм видит технический совет, но не находит подтверждения, что его написал человек с реальным бэкграундом, статья никогда не попадет в умный сниппет. Поисковые системы боятся транслировать недостоверную информацию, поэтому фактор доверия к автору стал техническим фактором ранжирования».
Ошибки оптимизации: что блокирует попадание сайта в блоки умных ответов
Попытки обмануть алгоритмы ИИ старыми методами приводят к пессимизации сайта или полному выпадению из выдачи. Нейросети обучены распознавать манипуляции с контентом на лету.
Ниже собраны критические ошибки, которые совершают владельцы сайтов при попытке адаптироваться под требования нового поиска:
- Генерация нередактируемого ИИ-текста. Публикация статей, созданных в ChatGPT без глубокого фактчекинга и стилистической правки человеком. Подобные тексты часто содержат логические галлюцинации и легко вычисляются спам-фильтрами поисковиков.
- Скрытие важной информации под интерактивными элементами. Размещение ответов на частые вопросы внутри раскрывающихся спойлеров (аккордеонов), которые загружаются только при помощи сложных JS-скриптов. Если поисковый робот не сможет быстро прочитать этот текст при первичном рендеринге, данные не попадут в умный ответ.
- Кликбейт и несоответствие заголовков содержанию. Когда заголовок обещает дать конкретную инструкцию, а внутри пользователя ждет длинное рекламное описание услуг компании. Робот быстро фиксирует плохие поведенческие метрики и исключает страницу из базы ответов.
Также важно следить за тем, чтобы файлы robots.txt не блокировали доступ ИИ-ботов к стилям (CSS) и скриптам (JS). Современные парсеры оценивают страницу в полном графическом отображении, и если они видят сломанный макет, доверие к сайту падает.
Инструменты мониторинга видимости сайта в генеративном поиске
Традиционные сервисы съема позиций часто не умеют корректно фиксировать появление сайта в блоках ИИ-ответов, так как эти блоки динамичны и могут меняться в зависимости от истории запросов конкретного пользователя. Для отслеживания эффективности SEO-оптимизации под нейросети нужен комплексный подход.
Методы и инструменты контроля:
- Анализ логов сервера. Мониторинг заходов специализированных ботов (например, Google-Extended или специфических поисковых пауков Яндекса). Это позволяет понять, как часто нейросети сканируют ваш контент.
- Отслеживание CTR в панелях веб-мастеров. Если позиции по запросу остаются в топ-3, но кликабельность (CTR) резко падает, это явный маркер того, что в выдаче появился блок умного ответа, который забирает трафик. Контент нужно срочно перерабатывать, чтобы поисковик взял ваш сайт в качестве первоисточника для этого блока.
- Ручной мониторинг по маркерным запросам. Регулярная проверка ключевых коммерческих и информационных запросов в режиме инкогнито с фиксацией структуры ИИ-выдачи. Наличие ссылки на ваш ресурс в текстовых сносках генеративного блока — главный показатель успеха.
Необходимо смещать фокус с отслеживания абстрактных позиций на контроль общего объема целевого трафика и количества лидов. Качественный переход из блока SGE часто приносит более мотивированного покупателя, так как он уже ознакомился с краткой информацией и перешел на сайт за конкретным решением.
Практическое руководство по переработке старого контента под стандарты ИИ
Большинство сайтов уже имеют огромный массив текстовых данных, который создавался годами. Вместо написания новых статей с нуля, гораздо эффективнее и дешевле провести аудит и модернизацию старого контента, адаптировав его под блоки быстрых ответов.
Пошаговый алгоритм оптимизации существующего контента:
- Выделение страниц с существующим трафиком. Найдите статьи, которые уже находятся на второй-третьей странице выдачи по целевым запросам. У них есть базовый авторитет, и им нужен минимальный импульс для попадания в ИИ-выдачу.
- Внедрение блока "Главное за 30 секунд". В самом начале статьи добавьте маркированный список, содержащий краткие выводы всего материала. Это идеальный триггер для парсинга поисковыми роботами.
- Замена размытых фраз конкретными определениями. Если в тексте написано «Стоимость услуг зависит от многих факторов и рассчитывается индивидуально», замените это на таблицу с четкими вилками цен или параметрами, влияющими на смету. ИИ любит цифры и конкретику, а не уклонение от ответа.
Регулярное обновление старых материалов показывает поисковым роботам, что сайт активно поддерживается, а информация на нем остается актуальной, что напрямую влияет на удержание позиций в эпоху умных алгоритмов.
Заключение
Интеграция искусственного интеллекта в поисковую выдачу — это не смерть SEO, а его переход на новый, более качественный уровень. Выигрывают те проекты, которые отказываются от штамповки пустых текстов ради объема и переходят к созданию структурированного, глубокого и авторитетного контента. Чтобы сайт стал донором для умных ответов SGE и Яндекса, необходимо выстраивать четкую архитектуру страниц, внедрять микроразметку, использовать таблицы и давать прямые ответы на сложные вопросы пользователей без лишней воды.
Адаптация ресурса под требования генеративного поиска требует серьезных технических знаний, аналитической работы и постоянного тестирования. Если вы хотите, чтобы ваш бизнес оставался заметным в новой реальности и привлекал клиентов из умного поиска, доверьте эту задачу профессионалам.
Специалисты поисковой оптимизации помогут перестроить структуру вашего ресурса, внедрить актуальные форматы разметки и защитить сайт от падения трафика. Для комплексного аудита и разработки эффективной контент-стратегии обратитесь в SEO студию "Элегрант" по телефону +7 (982) 764-53-46.